Позиционное кодирование
Вы узнаете
Как синусы и косинусы убывающих частот дают каждой позиции свой вектор и почему сдвиг это поворот.
Внимание видит свой вход как множество, поэтому порядок слов нужно к ним добавить. Синусоидальное кодирование даёт каждой позиции d чисел: sin и cos позиции, умноженной на частоту, которая от пары к паре падает в 10000^(2/d) раз. При d = 8 четыре пары поворачиваются на 1, 0.1, 0.01 и 0.001 радиана за позицию, как стрелки четырёх часов: позиция 5 читает -0.959, 0.284 в быстрой паре и 0.005, 1.000 в медленной. Длина каждой пары равна 1, и сдвиг на k позиций поворачивает каждую пару на свой постоянный угол. Спека positional_encoding.t27 вычисляет каждое значение.
Попробовать
Шагните с позиции 0 на 1 и посмотрите, какие часы двигаются; затем перейдите на 37 и найдите пару, которая всё ещё смотрит вверх.
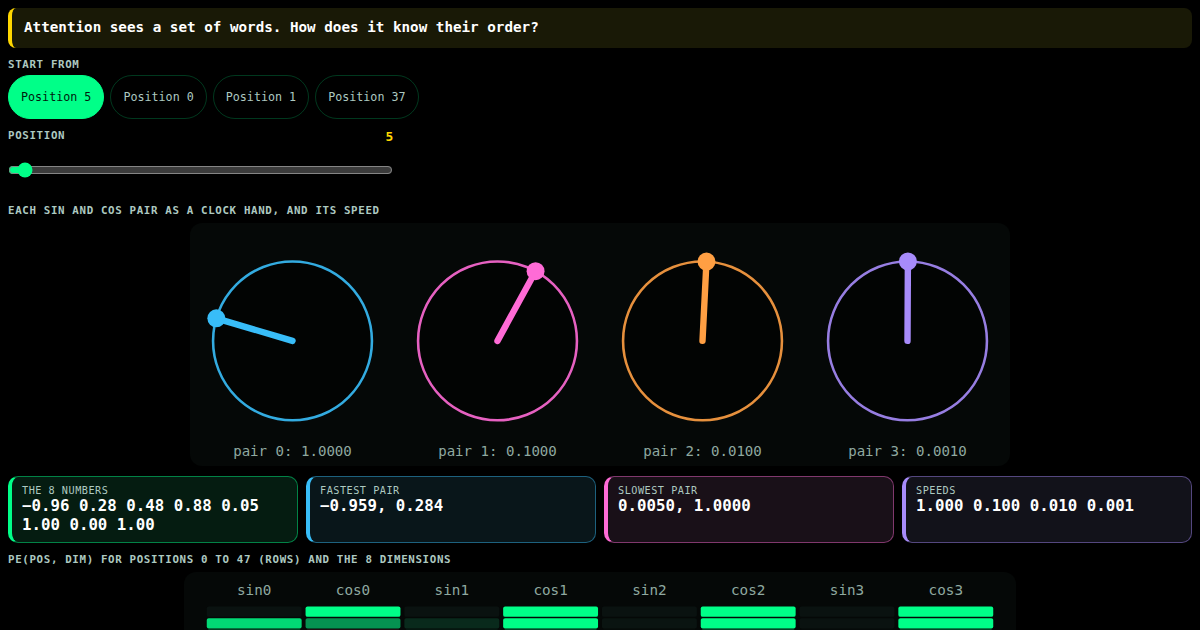
Every position gets 8 numbers, sines and cosines at frequencies falling by 10 per pair. Drag the position: the fast clock spins, the slow ones barely move, and the stripes show all 48 rows.
specs/ml/transformer/positional_encoding.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Uses sin/cos at different frequencies for each dimension | φ² + 1/φ² = 3 | TRINITY

// #8980: forward read an undeclared `d_model`, called `math::pow` / `math::sin` /
// `math::cos`, computed each encoding into a local and dropped it, and grew the
// frequency with the dimension where Vaswani et al. (2017) shrink it. It now
// writes the sinusoidal encoding
//   PE(pos, 2i) = sin(pos / 10000^(2i / d)),  PE(pos, 2i + 1) = cos(pos / 10000^(2i / d))
// for each position into a positions x d_model buffer.

module PositionalEnc;
    use base::types;
    use math::constants;

    // ═══════════════════════════════════════════════════════════
    // 1. Constants
    // ═══════════════════════════════════════════════════════════

    const DEFAULT_MAX_LEN : u32 = 2048;

    // ═══════════════════════════════════════════════════════════
    // 2. Types
    // ═══════════════════════════════════════════════════════════

    pub const PosEncConfig = struct {
        d_model : u32,
        max_len : u32,
    };

    // ═══════════════════════════════════════════════════════════
    // 3. Core Functions
    // ═══════════════════════════════════════════════════════════

    // 1 / 10000^(2i / d) = exp(-(2i / d) ln 10000)
    fn inv_freq(pair: u32, d_model: u32) -> f32 {
        return exp(-(@as(f32, @floatFromInt(2 * pair)) / @as(f32, @floatFromInt(d_model))) * log(@as(f32, 10000.0)));
    }

    fn forward(positions: []const u32, config: PosEncConfig, out: []f32) -> void {
        var p : usize = 0;
        while (p < positions.len) {
            const pos : f32 = @as(f32, @floatFromInt(positions[p]));
            var dim : u32 = 0;
            while (dim < config.d_model) {
                const angle = pos * inv_freq(dim / 2, config.d_model);
                if (dim % 2 == 0) {
                    out[p * config.d_model + dim] = sin(angle);
                } else {
                    out[p * config.d_model + dim] = cos(angle);
                }
                dim = dim + 1;
            }
            p = p + 1;
        }
    }

    // PE(pos, dim) for d_model 8
    fn pe(pos: u32, dim: usize) -> f32 {
        const positions : [1]u32 = [pos];
        var out : [8]f32 = [9.0] ** 8;
        forward(&positions, PosEncConfig{ .d_model = 8, .max_len = DEFAULT_MAX_LEN }, &out);
        return out[dim];
    }

    // ═══════════════════════════════════════════════════════════
    // TDD: Tests (from .tri behaviors)
    // ═══════════════════════════════════════════════════════════

    // pos 1, d 8: dims 0/1 use frequency 1, dims 2/3 use 1/10 (10000^(2/8) = 10)
    test forward_basic_case
        given s0 = pe(1, 0)
        when s2 = pe(1, 2)
        then @abs(s0 - 0.8414710) < 0.000001 and @abs(pe(1, 1) - 0.5403023) < 0.000001 and @abs(s2 - 0.0998334) < 0.000001 and @abs(pe(1, 3) - 0.9950042) < 0.000001

    // Position 0 encodes as (0, 1, 0, 1, ...)
    test forward_simple
        given s = pe(0, 6)
        when c = pe(0, 7)
        then s == 0.0 and c == 1.0

    // Each sin/cos pair lies on the unit circle
    test forward_pairs_are_unit_vectors
        given p = pe(37, 2) * pe(37, 2) + pe(37, 3) * pe(37, 3)
        then @abs(p - 1.0) < 0.000001

    invariant positional_encoding_max_len_is_positive
        assert DEFAULT_MAX_LEN > 0
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.