Блок энкодера
Вы узнаете
Что один блок энкодера трансформера делает со своим входом и что меняет перенос нормализаций вперёд.
Слой трансформера это два подслоя, каждый обёрнут остаточным сложением и нормализацией слоя: самовнимание смешивает позиции, затем сеть прямого распространения ширины 8 работает с каждой позицией отдельно. В порядке post-norm из исходной статьи блок кончается нормализацией, поэтому у каждой строки выхода среднее 0 и дисперсия 1.000. Pre-norm ставит нормализации перед каждым подслоем и кончается остаточным сложением, поэтому его строки выходят с дисперсиями 2.73, 3.33 и 0.96; глубокие стопки так учатся легче, с одной нормализацией в самом верху. Спека encoder_block.t27 прогоняет один блок на 3 позициях, d_model 4 и 2 головах.
Попробовать
Переключайтесь между post-norm и pre-norm и читайте дисперсии строк; затем найдите позицию, которую голова 1 читает больше всего.
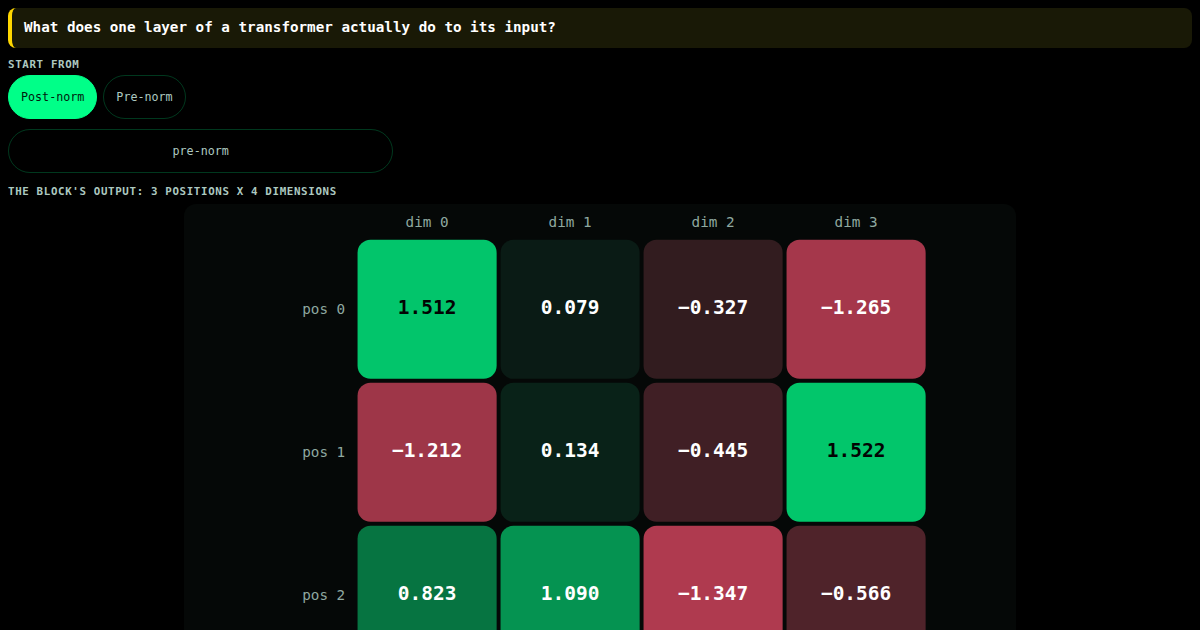
Three positions through one transformer block: attention, a residual, a feed-forward net and layer norm. Post-norm ends every row at mean 0 and variance 1; pre-norm does not.
specs/ml/transformer/encoder_block.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Standard Transformer encoder block with residual connections | φ² + 1/φ² = 3 | TRINITY

// #8980: attention and the FFN returned their input ("in real implementation
// ..."), forward skipped both residuals, and the tests asked only for a non-empty
// output from undeclared `default_input()`. The block now computes the Transformer
// encoder layer over a seq x d_model input. Attention is multi-head scaled
// dot-product, softmax(q k^T / sqrt(d_head)) v per head, with identity projections.
// Then come the position-wise FFN and two residual + layer-norm steps: post-norm
// LN(x + f(x)) by default, pre-norm x + f(LN(x)) when use_pre_norm is set.

module EncoderBlock;
    use base::types;
    use math::constants;

    // ═══════════════════════════════════════════════════════════
    // 1. Constants
    // ═══════════════════════════════════════════════════════════

    const DEFAULT_D_MODEL : u32 = 512;
    const DEFAULT_N_HEADS : u32 = 8;
    const DEFAULT_D_FF : u32 = 2048;
    const DEFAULT_DROPOUT : f32 = 0.1;

    // ═══════════════════════════════════════════════════════════
    // 2. Types
    // ═══════════════════════════════════════════════════════════

    pub const EncoderBlockConfig = struct {
        d_model : u32,
        n_heads : u32,
        d_ff : u32,
        dropout : f32,
        use_pre_norm : bool,
    };

    pub const FFNWeights = struct {
        w1 : []const f32,
        b1 : []const f32,
        w2 : []const f32,
        b2 : []const f32,
    };

    // ═══════════════════════════════════════════════════════════
    // 3. Core Functions
    // ═══════════════════════════════════════════════════════════

    // q, k, v and out are seq x d_model; attn_weights is n_heads x seq x seq. Head h uses
    // columns h * d_head .. (h + 1) * d_head.
    fn multi_head_attention(query: []const f32, key: []const f32, value: []const f32, seq: usize, n_heads: u32, d_model: u32, out: []f32, attn_weights: []f32) -> void {
        const d_head : usize = d_model / n_heads;
        const scale : f32 = 1.0 / sqrt(@as(f32, @floatFromInt(d_head)));
        var h : usize = 0;
        while (h < n_heads) {
            var i : usize = 0;
            while (i < seq) {
                const row = attn_weights[(h * seq + i) * seq .. (h * seq + i + 1) * seq];
                var max_s : f32 = -1.0e30;
                var j : usize = 0;
                while (j < seq) {
                    var dot : f32 = 0.0;
                    var c : usize = 0;
                    while (c < d_head) {
                        dot = dot + query[i * d_model + h * d_head + c] * key[j * d_model + h * d_head + c];
                        c = c + 1;
                    }
                    row[j] = dot * scale;
                    max_s = @max(max_s, row[j]);
                    j = j + 1;
                }
                var sum : f32 = 0.0;
                j = 0;
                while (j < seq) {
                    row[j] = exp(row[j] - max_s);
                    sum = sum + row[j];
                    j = j + 1;
                }
                var c : usize = 0;
                while (c < d_head) {
                    var acc : f32 = 0.0;
                    j = 0;
                    while (j < seq) {
                        acc = acc + row[j] / sum * value[j * d_model + h * d_head + c];
                        j = j + 1;
                    }
                    out[i * d_model + h * d_head + c] = acc;
                    c = c + 1;
                }
                j = 0;
                while (j < seq) {
                    row[j] = row[j] / sum;
                    j = j + 1;
                }
                i = i + 1;
            }
            h = h + 1;
        }
    }

    // out = W2 relu(W1 x + b1) + b2 for one row; hidden is d_ff floats of scratch.
    // Dropout is the identity at inference, which is what this block computes.
    fn feed_forward(input: []const f32, weights: FFNWeights, d_model: u32, d_ff: u32, hidden: []f32, out: []f32) -> void {
        var f : usize = 0;
        while (f < d_ff) {
            var z : f32 = weights.b1[f];
            var j : usize = 0;
            while (j < d_model) {
                z = z + weights.w1[f * d_model + j] * input[j];
                j = j + 1;
            }
            hidden[f] = @max(z, 0.0);
            f = f + 1;
        }
        var o : usize = 0;
        while (o < d_model) {
            var y : f32 = weights.b2[o];
            f = 0;
            while (f < d_ff) {
                y = y + weights.w2[o * d_ff + f] * hidden[f];
                f = f + 1;
            }
            out[o] = y;
            o = o + 1;
        }
    }

    // (x - mean) / sqrt(var + 1e-5), no learned scale or shift
    fn layer_norm(x: []const f32, out: []f32) -> void {
        var mean : f32 = 0.0;
        var k : usize = 0;
        while (k < x.len) {
            mean = mean + x[k];
            k = k + 1;
        }
        mean = mean / @as(f32, @floatFromInt(x.len));
        var variance : f32 = 0.0;
        k = 0;
        while (k < x.len) {
            variance = variance + (x[k] - mean) * (x[k] - mean);
            k = k + 1;
        }
        variance = variance / @as(f32, @floatFromInt(x.len));
        k = 0;
        while (k < x.len) {
            out[k] = (x[k] - mean) / sqrt(variance + 0.00001);
            k = k + 1;
        }
    }

    // input and out are seq x d_model. scratch needs 3 seq d_model + n_heads seq^2 + d_ff + d_model floats.
    fn forward(input: []const f32, seq: usize, ffn: FFNWeights, config: EncoderBlockConfig, out: []f32, scratch: []f32) -> void {
        const n : usize = seq * config.d_model;
        const d : usize = config.d_model;
        const normed = scratch[0..n];
        const attn = scratch[n .. 2 * n];
        const mid = scratch[2 * n .. 3 * n];
        const weights = scratch[3 * n .. 3 * n + config.n_heads * seq * seq];
        const rest = 3 * n + config.n_heads * seq * seq;
        const hidden = scratch[rest .. rest + config.d_ff];
        const row = scratch[rest + config.d_ff .. rest + config.d_ff + d];
        var t : usize = 0;
        if (config.use_pre_norm) {
            while (t < seq) {
                layer_norm(input[t * d .. (t + 1) * d], normed[t * d .. (t + 1) * d]);
                t = t + 1;
            }
            multi_head_attention(normed, normed, normed, seq, config.n_heads, config.d_model, attn, weights);
            var k : usize = 0;
            while (k < n) {
                mid[k] = input[k] + attn[k];
                k = k + 1;
            }
            t = 0;
            while (t < seq) {
                layer_norm(mid[t * d .. (t + 1) * d], normed[t * d .. (t + 1) * d]);
                feed_forward(normed[t * d .. (t + 1) * d], ffn, config.d_model, config.d_ff, hidden, row);
                var c : usize = 0;
                while (c < d) {
                    out[t * d + c] = mid[t * d + c] + row[c];
                    c = c + 1;
                }
                t = t + 1;
            }
            return;
        }
        multi_head_attention(input, input, input, seq, config.n_heads, config.d_model, attn, weights);
        var k : usize = 0;
        while (k < n) {
            normed[k] = input[k] + attn[k];
            k = k + 1;
        }
        t = 0;
        while (t < seq) {
            layer_norm(normed[t * d .. (t + 1) * d], mid[t * d .. (t + 1) * d]);
            feed_forward(mid[t * d .. (t + 1) * d], ffn, config.d_model, config.d_ff, hidden, row);
            var c : usize = 0;
            while (c < d) {
                normed[t * d + c] = mid[t * d + c] + row[c];
                c = c + 1;
            }
            layer_norm(normed[t * d .. (t + 1) * d], out[t * d .. (t + 1) * d]);
            t = t + 1;
        }
    }

    // The fixture: seq 3, d_model 4, 2 heads, d_ff 8
    fn cfg(pre_norm: bool) -> EncoderBlockConfig {
        return EncoderBlockConfig{ .d_model = 4, .n_heads = 2, .d_ff = 8, .dropout = DEFAULT_DROPOUT, .use_pre_norm = pre_norm };
    }

    fn fixture_input(x: []f32) -> void {
        const v : [12]f32 = [1.0, 0.0, 0.5, -1.0, 0.0, 1.0, -0.5, 2.0, 1.0, 1.0, 0.0, 0.0];
        var k : usize = 0;
        while (k < 12) {
            x[k] = v[k];
            k = k + 1;
        }
    }

    // which: 0 = out[index], 1 = attn_weights[index] of self-attention on the fixture
    fn attention_at(which: u8, index: usize) -> f32 {
        var x : [12]f32 = undefined;
        fixture_input(&x);
        var out : [12]f32 = [9.0] ** 12;
        var weights : [18]f32 = [9.0] ** 18;
        multi_head_attention(&x, &x, &x, 3, 2, 4, &out, &weights);
        if (which == 0) {
            return out[index];
        }
        return weights[index];
    }

    // Two keys equal: attention splits evenly and returns the mean of the values
    fn tie_attention(index: usize) -> f32 {
        const q : [2]f32 = [1.0, 1.0];
        const k : [2]f32 = [2.0, 2.0];
        const v : [2]f32 = [4.0, 10.0];
        var out : [2]f32 = [0.0] ** 2;
        var weights : [4]f32 = [0.0] ** 4;
        multi_head_attention(&q, &k, &v, 2, 1, 1, &out, &weights);
        return out[index];
    }

    fn ffn_fill(w1: []f32, b1: []f32, w2: []f32, b2: []f32) -> void {
        var k : usize = 0;
        while (k < 32) {
            w1[k] = @as(f32, @floatFromInt((k * 5 + 1) % 9)) / 8.0 - 0.5;
            w2[k] = @as(f32, @floatFromInt((k * 7 + 2) % 9)) / 8.0 - 0.5;
            k = k + 1;
        }
        k = 0;
        while (k < 8) {
            b1[k] = 0.1;
            k = k + 1;
        }
        k = 0;
        while (k < 4) {
            b2[k] = -0.1;
            k = k + 1;
        }
    }

    // which: 0 = out[index]; 1 = mean of row `index`; 2 = variance of row `index`
    fn block_at(pre_norm: bool, which: u8, index: usize) -> f32 {
        var x : [12]f32 = undefined;
        fixture_input(&x);
        var w1 : [32]f32 = undefined;
        var b1 : [8]f32 = undefined;
        var w2 : [32]f32 = undefined;
        var b2 : [4]f32 = undefined;
        ffn_fill(&w1, &b1, &w2, &b2);
        var out : [12]f32 = [9.0] ** 12;
        var scratch : [3 * 12 + 18 + 8 + 4]f32 = undefined;
        forward(&x, 3, FFNWeights{ .w1 = &w1, .b1 = &b1, .w2 = &w2, .b2 = &b2 }, cfg(pre_norm), &out, &scratch);
        if (which == 0) {
            return out[index];
        }
        var mean : f32 = 0.0;
        var c : usize = 0;
        while (c < 4) {
            mean = mean + out[index * 4 + c] / 4.0;
            c = c + 1;
        }
        if (which == 1) {
            return mean;
        }
        var variance : f32 = 0.0;
        c = 0;
        while (c < 4) {
            variance = variance + (out[index * 4 + c] - mean) * (out[index * 4 + c] - mean) / 4.0;
            c = c + 1;
        }
        return variance;
    }

    // FFN on row (1, 0, 0.5, -1) of the fixture weights; out[index]
    fn ffn_at(index: usize) -> f32 {
        var w1 : [32]f32 = undefined;
        var b1 : [8]f32 = undefined;
        var w2 : [32]f32 = undefined;
        var b2 : [4]f32 = undefined;
        ffn_fill(&w1, &b1, &w2, &b2);
        const x : [4]f32 = [1.0, 0.0, 0.5, -1.0];
        var hidden : [8]f32 = undefined;
        var out : [4]f32 = [9.0] ** 4;
        feed_forward(&x, FFNWeights{ .w1 = &w1, .b1 = &b1, .w2 = &w2, .b2 = &b2 }, 4, 8, &hidden, &out);
        return out[index];
    }

    fn valid_input() -> u32 {
        return DEFAULT_D_MODEL / DEFAULT_N_HEADS;
    }

    // ═══════════════════════════════════════════════════════════
    // TDD: Tests (from .tri behaviors)
    // ═══════════════════════════════════════════════════════════

    // Every attention row is a distribution; equal keys give the mean of the values
    test multi_head_attention_basic_case
        given row_sum = attention_at(1, 0) + attention_at(1, 1) + attention_at(1, 2)
        when tied = tie_attention(0)
        then @abs(row_sum - 1.0) < 0.000001 and tied == 7.0 and tie_attention(1) == 7.0 and attention_at(0, 0) != 9.0

    // Heads are independent: head 1's weights (rows 9..17) differ from head 0's
    test multi_head_attention_heads_differ
        given w0 = attention_at(1, 1)
        when w1 = attention_at(1, 10)
        then w0 != w1 and w0 > 0.0 and w1 > 0.0

    // W2 relu(W1 x + b1) + b2 on the fixture row, worked by hand: (0.4125, ..., -0.178125)
    test feed_forward_basic_case
        given y0 = ffn_at(0)
        when y3 = ffn_at(3)
        then @abs(y0 - 0.4125) < 0.000001 and @abs(y3 + 0.178125) < 0.000001 and @abs(ffn_at(2) + 0.928125) < 0.000001

    // Post-norm: every output row has mean 0 and variance 1
    test forward_basic_case
        given mean1 = block_at(false, 1, 1)
        when var1 = block_at(false, 2, 1)
        then @abs(mean1) < 0.00001 and @abs(var1 - 1.0) < 0.001 and @abs(block_at(false, 1, 2)) < 0.00001

    // Pre-norm keeps the residual stream un-normalised, so it differs from post-norm
    test forward_pre_norm_differs
        given pre = block_at(true, 0, 0)
        when post = block_at(false, 0, 0)
        then pre != post and pre == pre

    // ═══════════════════════════════════════════════════════════
    // TDD: Invariants (from .tri constraints)
    // ═══════════════════════════════════════════════════════════

    // d_model % n_heads == 0
    invariant encoder_block_constraint_0
        assert DEFAULT_D_MODEL % DEFAULT_N_HEADS == 0 and cfg(false).d_model % cfg(false).n_heads == 0

    // d_ff >= d_model
    invariant encoder_block_constraint_1
        assert DEFAULT_D_FF >= DEFAULT_D_MODEL and cfg(false).d_ff >= cfg(false).d_model

    // name: encoder_block -- each head gets d_model / n_heads columns
    invariant encoder_block_constraint_2
        assert valid_input() == 64

    // "Vaswani et al. (2017) - Attention Is All You Need": dropout is a probability
    invariant encoder_block_constraint_3
        assert DEFAULT_DROPOUT >= 0.0 and DEFAULT_DROPOUT < 1.0

    // "Baevski et al. (2020) - Revisiting the Self-Attention": both norm placements are offered
    invariant encoder_block_constraint_4
        assert cfg(true).use_pre_norm and !cfg(false).use_pre_norm
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.