Раскодировать за один шаг
Вы узнаете
Почему формат с полями фиксированной длины раскодирует поля параллельно, а позит не может, как спека считает шаги.
Позит кладёт перед порядком режим переменной длины, поэтому декодер должен найти конец режима, прежде чем сможет прочитать что-то ещё. GF16 и IEEE FP16 держат каждое поле на фиксированном месте, поэтому все поля раскодируются сразу. gf_competitive.t27 считает шаги: 3 у FP16, 6 у POSIT16, 3 у GF16, и отмечает, какие можно выполнять параллельно. Это числа, вписанные в спеку, а не время, измеренное на железе.
Попробуйте
Найдите decode_complexity и три записи, которые она возвращает. Затем найдите инвариант, который сравнивает позит с GF16, и скажите, что добавило бы измерение времени на железе.
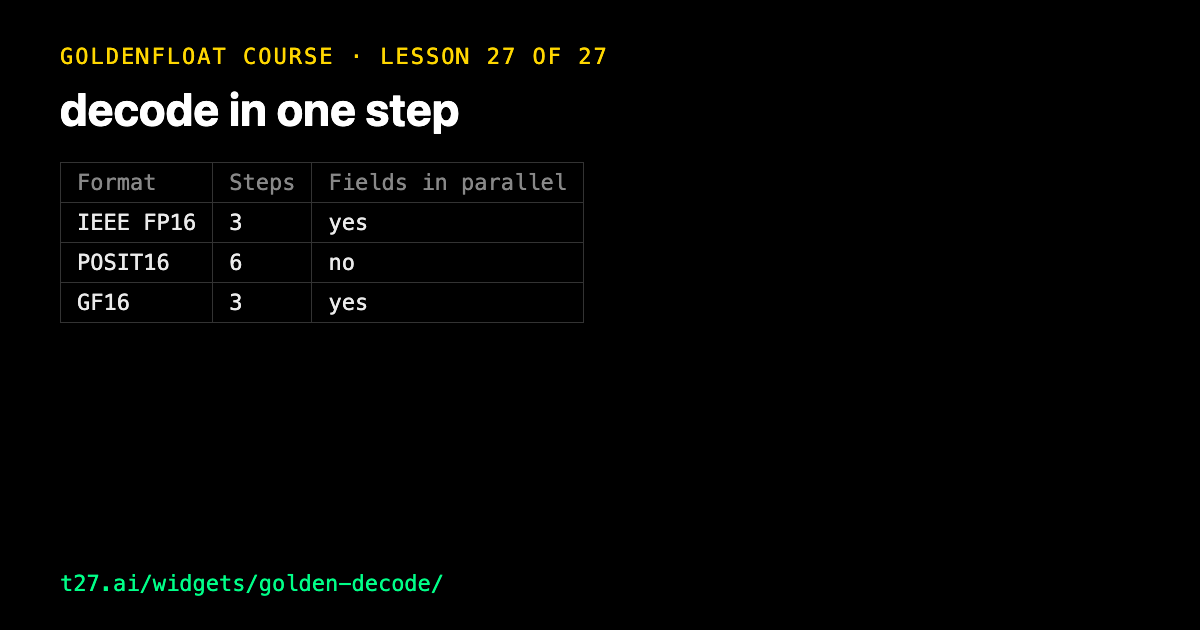
Decode steps as gf_competitive.t27 counts them, read from gf_competitive.t27. Lesson 27 of the GoldenFloat course.
specs/math/gf_competitive.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/math/gf_competitive.t27
// GoldenFloat Competitive Analysis — GF vs Posit vs IEEE 754
// MATH-COMPETITIVE-001 — Decode latency, parallelism, hardware efficiency
//
// Ring 051: Competitive analysis showing GF's structural advantages
// Main result: GF has O(1) parallel decode vs Posit's O(N) sequential

module GFCompetitive {
    use math::constants;
    use math::sacred_physics;

    // ═══════════════════════════════════════════════════════════════════════════
    // 1. Decode Complexity Analysis
    // ═════════════════════════════════════════════════════════════════════════════════════════

    // Decode operation counts (worst case)
    struct DecodeComplexity {
        format        : string,
        steps_sequential : u8,
        steps_parallel   : u8,
        can_parallelize : bool,
    }

    // Worst-case decode steps for each format
    fn decode_complexity() -> [3]DecodeComplexity {
        return [
            DecodeComplexity{
                format = "IEEE_754_FP16",
                steps_sequential = 3,   // sign, exp, mantissa (fixed position)
                steps_parallel = 3,     // all fields decodeable in parallel
                can_parallelize = true,
            },
            DecodeComplexity{
                format = "POSIT16",
                steps_sequential = 6,    // regime (variable) + sign + exp + mantissa
                steps_parallel = 6,
                can_parallelize = false, // regime detection is sequential
            },
            DecodeComplexity{
                format = "GF16",
                steps_sequential = 3,    // sign (trit), exp (fixed), mantissa (fixed)
                steps_parallel = 3,
                can_parallelize = true,  // all fields decodeable in parallel
            },
        ];
    }

    // ═══════════════════════════════════════════════════════════════════════════
    // Tests
    // ═════════════════════════════════════════════════════════════════════════════════════════

    test "decode_complexity_returns_3_formats" {
        let complexity = decode_complexity();
        assert(complexity.len() == 3);
    }

    test "gf16_can_parallelize" {
        let complexity = decode_complexity();
        assert(complexity[2].can_parallelize);
    }

    test "posit_cannot_parallelize" {
        let complexity = decode_complexity();
        assert(!complexity[1].can_parallelize);
    }

    test "ieee754_fp16_can_parallelize" {
        let complexity = decode_complexity();
        assert(complexity[0].can_parallelize);
    }

    test "gf16_has_minimal_sequential_steps" {
        let complexity = decode_complexity();
        assert(complexity[2].steps_sequential == 3);
    }

    test "posit_has_more_sequential_steps" {
        let complexity = decode_complexity();
        assert(complexity[1].steps_sequential > complexity[2].steps_sequential);
    }

    // ═══════════════════════════════════════════════════════════════════════════
    // Invariants
    // ═════════════════════════════════════════════════════════════════════════════════════════

    invariant "decode_complexity_always_returns_3_entries" {
        let complexity = decode_complexity();
        assert(complexity.len() == 3);
    }

    invariant "gf16_can_parallelize_is_true" {
        let complexity = decode_complexity();
        assert(complexity[2].can_parallelize);
    }

    invariant "posit_has_more_sequential_steps_than_gf16" {
        let complexity = decode_complexity();
        assert(complexity[1].steps_sequential >= complexity[2].steps_sequential);
    }

    invariant "all_formats_have_positive_steps" {
        let complexity = decode_complexity();
        for c in complexity {
            assert(c.steps_sequential > 0);
            assert(c.steps_parallel > 0);
        }
    }

    // ═══════════════════════════════════════════════════════════════════════════
    // Benchmarks
    // ═════════════════════════════════════════════════════════════════════════════════════════

    bench "decode_complexity" {
        let iterations = 10000;
        for _ in 0..iterations {
            let _ = decode_complexity();
        }
    }

}
Все уроки
Модуль 1 · Правило и его числа
Одно правило делит каждую ширину, отношение, к которому оно стремится, и числа Люка за тройкой 3.
Модуль 2 · Почему phi, почему три
Почему деление идёт по phi, почему основание три и как спека проверяет, что GF16 хранит phi.
Модуль 3 · Малые ступени: от GF4 до GF8
GF4, GF6 и GF8 — меньше всего битов, и округление до целых битов стоит здесь дороже всего.
Модуль 4 · От десяти до четырнадцати битов
GF10, GF12 и GF14 и то, как расстояние до 1 / phi меняется с ростом слова.
Модуль 5 · GF16 в работе
Основной 16-битный формат, скалярное произведение из двух слагаемых в GF-T16, затем GF20 и GF24.
Модуль 6 · От GF32 до GF64
GF32 рядом с IEEE single, GF48 без пары в IEEE, GF64 рядом с IEEE double.
Модуль 7 · От GF96 до GF256
GF96, GF128 и GF256, где спеки держат раскладку инвариантами.
Модуль 8 · Самые широкие ступени, затем триты
GF512 и GF1024, две самые широкие ступени, затем GF-T8, где порядок уходит в триты.
Модуль 9 · Ещё триты, затем декодирование
GF-T16 и GF-T32, затем почему фиксированные поля декодируются параллельно, а posit — нет.