tanh и насыщение
Вы узнаете
Почему tanh центрирована на нуле и где её наклон падает так низко, что нейрон перестаёт учиться.
tanh это сигмоида, растянутая на -1..1 и центрированная на 0, поэтому слой нейронов tanh передаёт дальше значения со средним около нуля, а её наклон в центре достигает 1. Она тоже насыщается: при 2.5 выход 0.9866, а наклон всего 0.0266. Красная полоса отмечает все входы, где наклон меньше 0.1, дальше примерно 1.8 в обе стороны, и нейрон, чьи входы живут там, почти не учится. Спека tanh_activation.t27 вычисляет кривую, наклон и свой пакет, tanh от 0, 1 и 2: 0, 0.762 и 0.964.
Попробовать
Тяните x, пока не начнётся полоса, и прочитайте наклон там; затем сравните наклон в 0 и при 2.5.
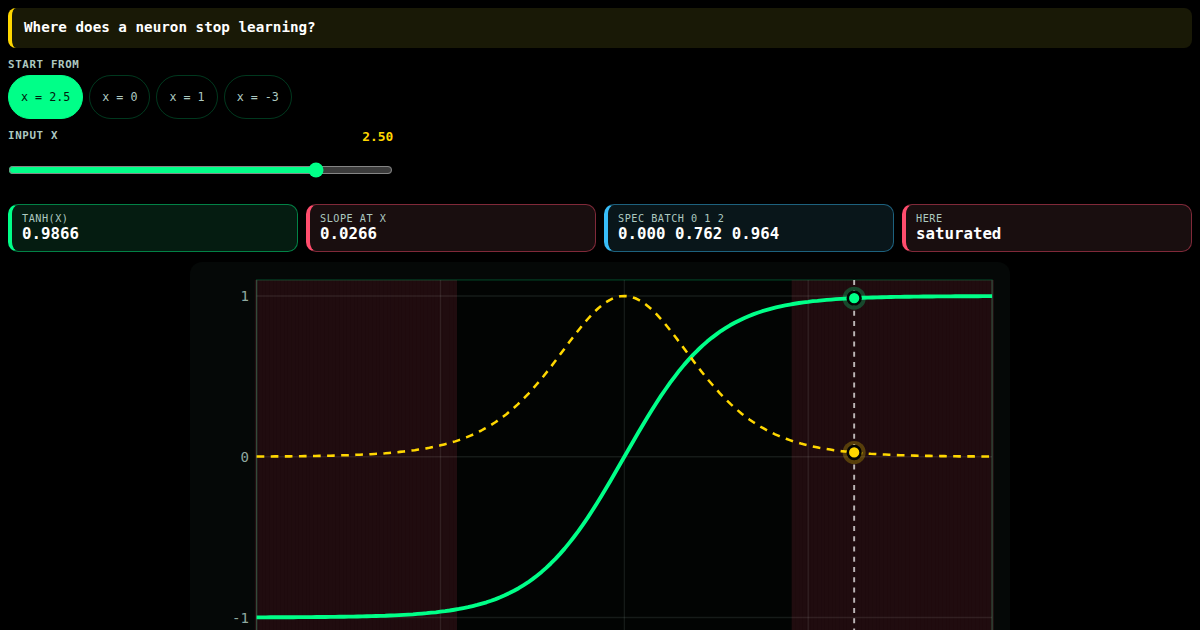
Drag along tanh: it is centred on zero, and where it flattens out its slope drops under 0.1. The red band shows every input where the gradient has all but stopped.
specs/ml/activation/tanh_activation.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Derivative (can compute from output) | φ² + 1/φ² = 3 | TRINITY

// #8980: `math::exp` named a module this spec never imports, and
// forward_batch allocated with `[]f32{input.len}`. tanh is now computed in the
// form that cannot overflow: exp(2|x|) reaches inf in f32 at |x| = 45, and
// inf / inf is NaN.

module Tanh;
    use base::types;
    use math::constants;

    // ═══════════════════════════════════════════════════════════
    // 2. Types
    // ═══════════════════════════════════════════════════════════

    pub const TanhConfig = struct {
        none : void,
    };

    // ═══════════════════════════════════════════════════════════
    // 3. Core Functions
    // ═══════════════════════════════════════════════════════════

    // tanh(x) = (1 - e^(-2|x|)) / (1 + e^(-2|x|)), with the sign of x
    fn forward(x: f32) -> f32 {
        if (x < 0.0) {
            return -forward(-x);
        }
        const t = exp(-2.0 * x);
        return (1.0 - t) / (1.0 + t);
    }

    // forward_batch: output[i] = tanh(input[i])
    fn forward_batch(input: []const f32, output: []f32) -> void {
        var i : usize = 0;
        while (i < input.len) {
            output[i] = forward(input[i]);
            i = i + 1;
        }
    }

    // tanh'(x) = 1 - tanh(x)^2
    fn derivative(x: f32) -> f32 {
        const tanh_x = forward(x);
        return 1.0 - (tanh_x * tanh_x);
    }

    // Given y = tanh(x), the derivative is 1 - y^2
    fn derivative_from_output(tanh_x: f32) -> f32 {
        return 1.0 - (tanh_x * tanh_x);
    }

    fn batch_at(index: usize) -> f32 {
        const input : [3]f32 = [0.0, 1.0, 2.0];
        var output : [3]f32 = [0.0] ** 3;
        forward_batch(&input, &output);
        return output[index];
    }

    // ═══════════════════════════════════════════════════════════
    // TDD: Tests (from .tri behaviors)
    // ═══════════════════════════════════════════════════════════

    // tanh(0) = 0, tanh(1) = 0.7615942, tanh is odd
    test forward_basic_case
        given input = 0.0
        when result = forward(input)
        then result == 0.0 and @abs(forward(1.0) - 0.7615942) < 0.000001 and forward(-1.0) == -forward(1.0)

    // exp(2x) is inf in f32 here; the stable form still gives 1, not NaN
    test forward_saturates_without_overflow
        given input = 100.0
        when result = forward(input)
        then result == 1.0 and forward(-100.0) == -1.0

    test forward_batch_basic_case
        given first = batch_at(0)
        when second = batch_at(1)
        then first == 0.0 and second > 0.0 and second < 1.0 and batch_at(2) > second

    test derivative_basic_case
        given input = 0.0
        when result = derivative(input)
        then result == 1.0

    test derivative_from_output_basic_case
        given input = 0.5
        when tanh_result = forward(input)
        then derivative_from_output(tanh_result) > 0.0 and derivative_from_output(tanh_result) < 1.0 and derivative_from_output(tanh_result) == derivative(input)

    test derivative_matches_finite_difference
        given slope = (forward(0.5 + 0.001) - forward(0.5 - 0.001)) / 0.002
        when result = derivative(0.5)
        then @abs(result - slope) < 0.001
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.