Среднеквадратичная ошибка
Вы узнаете
Как MSE превращает каждый промах в одно число, почему она гоняется за большими ошибками и куда смотрит её градиент.
Функция потерь превращает все промахи модели в одно число, которое нужно уменьшать. Среднеквадратичная ошибка усредняет квадраты промахов: предсказания 1.5, 2 и 2 против целей 1, 2 и 3 стоят (0.25 + 0 + 1) / 3 = 0.4167. Из-за квадрата промах на 2 стоит в 4 раза больше промаха на 1, поэтому MSE гоняется за большими ошибками. Её градиент для каждого предсказания равен 2 (p - t) / n, здесь 0.333, 0 и -0.667: каждое предсказание толкается обратно к своей цели. Как функция одного предсказания потеря это парабола, чаша с одним дном. Спека mse_loss.t27 вычисляет потерю и градиент.
Попробовать
Передвиньте предсказание 2 на его цель и прочитайте потерю; затем ведите по чаше и найдите её дно.
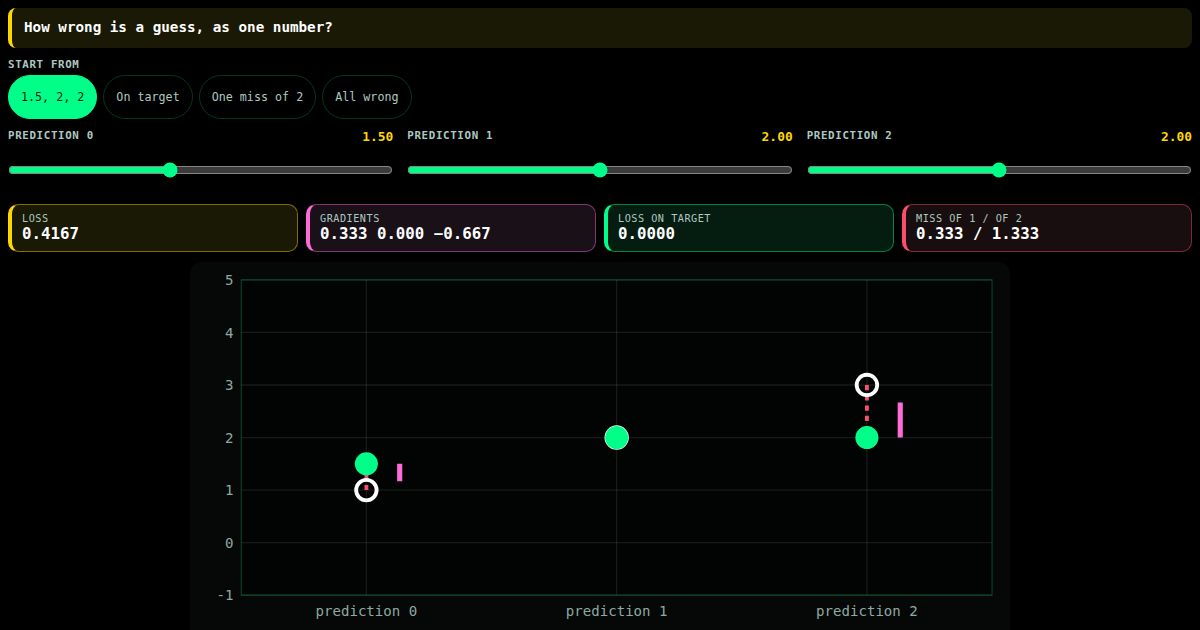
Move three predictions against the targets 1, 2 and 3: the loss is the mean of the squared misses, its bowl is a parabola, and each gradient points its prediction back at the target.
specs/ml/loss/mse_loss.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Penalizes large errors more heavily | φ² + 1/φ² = 3 | TRINITY
// Restored 2026-10-05 from trinity specs/algo/mse_loss.tri: the port kept only
// the first parameter and returned void, so forward computed a value and
// threw it away, and every test asserted `result != undefined`.

module MseLoss;
    use base::types;
    use math::constants;

    // ═══════════════════════════════════════════════════════════
    // 2. Types
    // ═══════════════════════════════════════════════════════════

    // reduction: "mean", "sum" or "none" (from the .tri). forward below is the
    // .tri's mean; the field is carried, not yet read.
    pub const MSELossConfig = struct {
        reduction : []const u8,
    };

    // ═══════════════════════════════════════════════════════════
    // 3. Core Functions
    // ═══════════════════════════════════════════════════════════

    // forward(predictions, targets) -> mean((predictions - targets)^2); 0 for n = 0
    fn forward(predictions: []const f32, targets: []const f32) -> f32 {
        if (predictions.len == 0) {
            return 0.0;
        }
        var sum_loss : f32 = 0.0;
        var i : usize = 0;
        while (i < predictions.len) {
            const diff = predictions[i] - targets[i];
            sum_loss = sum_loss + diff * diff;
            i = i + 1;
        }
        return sum_loss / (predictions.len as f32);
    }

    // backward: grad_input[i] = 2 (predictions[i] - targets[i]) / n
    fn backward(predictions: []const f32, targets: []const f32, grad_input: []f32) -> void {
        if (predictions.len == 0) {
            return;
        }
        const scale = 2.0 / (predictions.len as f32);
        var i : usize = 0;
        while (i < predictions.len) {
            grad_input[i] = scale * (predictions[i] - targets[i]);
            i = i + 1;
        }
    }

    // ═══════════════════════════════════════════════════════════
    // TDD: Tests
    // ═══════════════════════════════════════════════════════════

    fn mse_at(p0: f32, p1: f32, p2: f32) -> f32 {
        const predictions : [3]f32 = [p0, p1, p2];
        const targets : [3]f32 = [1.0, 2.0, 3.0];
        return forward(&predictions, &targets);
    }

    fn mse_grad_at(p0: f32, p1: f32, p2: f32, index: usize) -> f32 {
        const predictions : [3]f32 = [p0, p1, p2];
        const targets : [3]f32 = [1.0, 2.0, 3.0];
        var grads : [3]f32 = [0.0] ** 3;
        backward(&predictions, &targets, &grads);
        return grads[index];
    }

    fn mse_empty() -> f32 {
        const none : [0]f32 = [];
        return forward(&none, &none);
    }

    test forward_zero_on_exact_match
        given result = mse_at(1.0, 2.0, 3.0)
        when also = mse_empty()
        then result == 0.0 and also == 0.0

    // errors (0.5, -1, 2): (0.25 + 1 + 4) / 3 = 1.75
    test forward_basic_case
        given result = mse_at(1.5, 1.0, 5.0)
        when flipped = mse_at(0.5, 3.0, 1.0)
        then @abs(result - 1.75) < 0.000001 and @abs(flipped - result) < 0.000001

    test backward_matches_finite_difference
        given slope = (mse_at(1.5, 1.001, 5.0) - mse_at(1.5, 0.999, 5.0)) / 0.002
        when result = mse_grad_at(1.5, 1.0, 5.0, 1)
        then @abs(result - slope) < 0.001 and @abs(result - (-2.0 / 3.0)) < 0.000001

    // ═══════════════════════════════════════════════════════════
    // TDD: Invariants
    // ═══════════════════════════════════════════════════════════

    invariant mse_zero_at_target
        assert mse_at(1.0, 2.0, 3.0) == 0.0
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.