Учим XOR
Вы узнаете
Почему один нейрон не может выучить XOR и как это делает скрытый слой, обученный обратным распространением.
XOR равен 1, когда ровно один из двух входов равен 1. Никакая прямая не отделяет случаи, дающие 1, от дающих 0, поэтому один нейрон выучить его не может. Скрытый слой изгибает пространство: спека обучает сеть 2-8-1 из ReLU обратным распространением, lr 0.05, из фиксированных начальных весов. Её потеря падает с 0.8896 в эпохе 1 до 1.8e-13 после 2000 эпох, а четыре ответа выходят в пределах 4e-7 от 0, 1, 1 и 0. Виджет проводит это обучение в вашем браузере, заново для каждой точки кривой. Спека mlp.t27 хранит сеть и тест, что она учится.
Попробовать
Отведите эпохи назад к 100 и прочитайте четыре ответа; затем найдите эпоху, где кривая перестаёт падать.
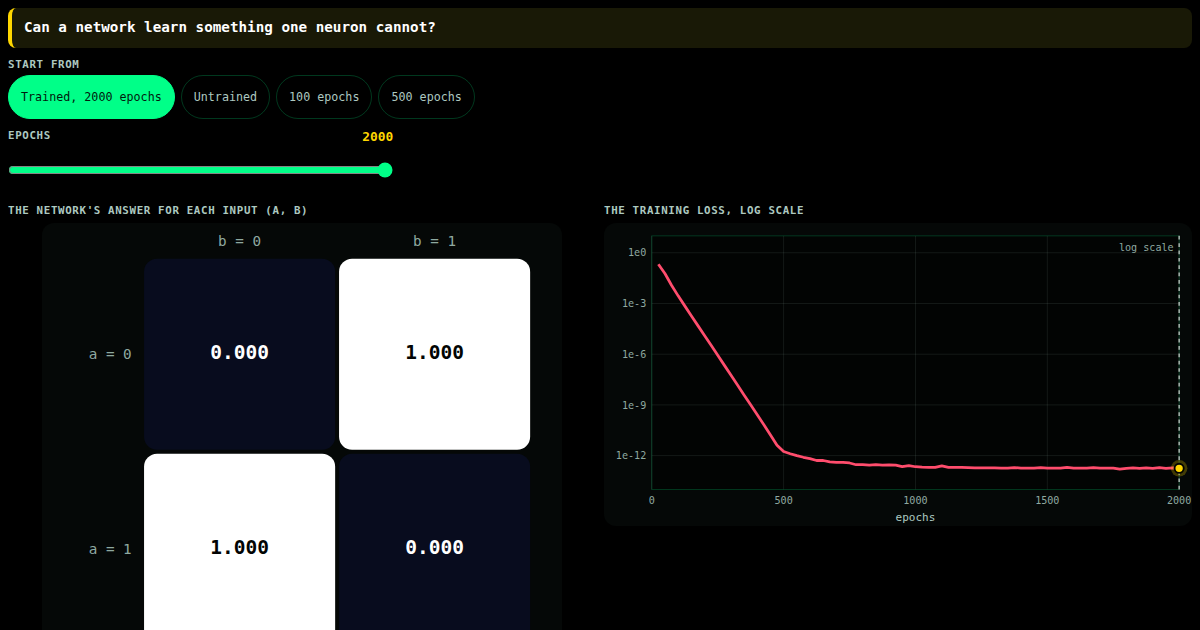
A 2-8-1 network trained by backpropagation in your browser: drag the epochs from 0 to 2000 and watch its four answers move to 0, 1, 1, 0 while the loss falls from 0.89 by twelve orders.
specs/ml/pathway/mlp.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// ReLU activation for hidden layers | φ² + 1/φ² = 3 | TRINITY

// #8980: forward computed the hidden layer and wrote it into `output` (the
// second layer never ran); init called an undeclared `alloc_f32`; the tests
// called undeclared `create_test_*` helpers; and the invariants asserted `true`.
// The MLP is now two layers, h = relu(W1 x + b1) and y = W2 h + b2, over buffers
// the caller owns. train_step adds backpropagation with an SGD update, and the
// tests train the network on XOR, which no single linear layer can fit.

module Mlp;
    use base::types;
    use math::constants;

    // ═══════════════════════════════════════════════════════════
    // 1. Constants
    // ═══════════════════════════════════════════════════════════

    const MNIST_INPUT_SIZE : u32 = 784;
    const MNIST_OUTPUT_SIZE : u32 = 10;
    const DEFAULT_HIDDEN_SIZE : u32 = 128;

    // ═══════════════════════════════════════════════════════════
    // 2. Types
    // ═══════════════════════════════════════════════════════════

    pub const MLPConfig = struct {
        input_size : u32,
        hidden_size : u32,
        output_size : u32,
    };

    pub const MLPState = struct {
        w1 : []f32,
        b1 : []f32,
        w2 : []f32,
        b2 : []f32,
    };

    // ═══════════════════════════════════════════════════════════
    // 3. Core Functions
    // ═══════════════════════════════════════════════════════════

    // One dense layer: out[o] = sum_i w[o * n_in + i] in[i] + b[o], relu when asked
    fn layer(input: []const f32, w: []const f32, b: []const f32, n_in: u32, n_out: u32, relu: bool, out: []f32) -> void {
        var o : usize = 0;
        while (o < n_out) {
            var sum : f32 = b[o];
            var i : usize = 0;
            while (i < n_in) {
                sum = sum + w[o * n_in + i] * input[i];
                i = i + 1;
            }
            if (relu and sum < 0.0) {
                sum = 0.0;
            }
            out[o] = sum;
            o = o + 1;
        }
    }

    // h = relu(W1 x + b1) into `hidden`, y = W2 h + b2 into `output`
    fn forward(input: []const f32, state: MLPState, hidden: []f32, output: []f32, config: MLPConfig) -> void {
        layer(input, state.w1, state.b1, config.input_size, config.hidden_size, true, hidden);
        layer(hidden, state.w2, state.b2, config.hidden_size, config.output_size, false, output);
    }

    // He-scaled deterministic init: w in [-1, 1) sqrt(2 / fan_in) from a fixed hash of the
    // index (salt tells the layers apart); every bias 0
    fn init_weights(w: []f32, fan_in: u32, salt: usize) -> void {
        const scale : f32 = sqrt(2.0 / @as(f32, @floatFromInt(fan_in)));
        var k : usize = 0;
        while (k < w.len) {
            const h : u32 = @as(u32, @intCast(((k + salt) * 2654435761) % 1000));
            w[k] = (@as(f32, @floatFromInt(h)) / 500.0 - 1.0) * scale;
            k = k + 1;
        }
    }

    fn zero(v: []f32) -> void {
        var k : usize = 0;
        while (k < v.len) {
            v[k] = 0.0;
            k = k + 1;
        }
    }

    fn init(state: MLPState, config: MLPConfig) -> void {
        init_weights(state.w1, config.input_size, 1);
        zero(state.b1);
        init_weights(state.w2, config.hidden_size, 7);
        zero(state.b2);
    }

    // One SGD step on the loss 0.5 * sum_o (y_o - t_o)^2; returns the loss before the step.
    //   d2_o = y_o - t_o                                   (output error)
    //   d1_i = [z_i > 0] sum_o W2[o][i] d2_o                (backpropagated through relu)
    //   W2 -= lr d2 h^T, b2 -= lr d2;  W1 -= lr d1 x^T, b1 -= lr d1
    fn train_step(input: []const f32, target: []const f32, state: MLPState, hidden: []f32, delta: []f32, output: []f32, lr: f32, config: MLPConfig) -> f32 {
        forward(input, state, hidden, output, config);
        var loss : f32 = 0.0;
        var o : usize = 0;
        while (o < config.output_size) {
            const e = output[o] - target[o];
            loss = loss + 0.5 * e * e;
            o = o + 1;
        }
        var i : usize = 0;
        while (i < config.hidden_size) {
            var back : f32 = 0.0;
            if (hidden[i] > 0.0) {
                o = 0;
                while (o < config.output_size) {
                    back = back + state.w2[o * config.hidden_size + i] * (output[o] - target[o]);
                    o = o + 1;
                }
            }
            delta[i] = back;
            i = i + 1;
        }
        o = 0;
        while (o < config.output_size) {
            const d2 = output[o] - target[o];
            i = 0;
            while (i < config.hidden_size) {
                state.w2[o * config.hidden_size + i] = state.w2[o * config.hidden_size + i] - lr * d2 * hidden[i];
                i = i + 1;
            }
            state.b2[o] = state.b2[o] - lr * d2;
            o = o + 1;
        }
        i = 0;
        while (i < config.hidden_size) {
            var j : usize = 0;
            while (j < config.input_size) {
                state.w1[i * config.input_size + j] = state.w1[i * config.input_size + j] - lr * delta[i] * input[j];
                j = j + 1;
            }
            state.b1[i] = state.b1[i] - lr * delta[i];
            i = i + 1;
        }
        return loss;
    }

    fn mnist() -> MLPConfig {
        return MLPConfig{ .input_size = MNIST_INPUT_SIZE, .hidden_size = DEFAULT_HIDDEN_SIZE, .output_size = MNIST_OUTPUT_SIZE };
    }

    // which: 0 = output[index], 1 = min over every output, 2 = number of outputs written,
    // on the MNIST shape with input pixel k = (k % 7) / 7
    fn mnist_forward(which: u8, index: usize) -> f32 {
        var w1 : [784 * 128]f32 = undefined;
        var b1 : [128]f32 = undefined;
        var w2 : [128 * 10]f32 = undefined;
        var b2 : [10]f32 = undefined;
        const state = MLPState{ .w1 = &w1, .b1 = &b1, .w2 = &w2, .b2 = &b2 };
        init(state, mnist());
        var input : [784]f32 = undefined;
        var k : usize = 0;
        while (k < 784) {
            input[k] = @as(f32, @floatFromInt(k % 7)) / 7.0;
            k = k + 1;
        }
        var hidden : [128]f32 = undefined;
        var output : [11]f32 = [-99.0] ** 11;
        forward(&input, state, &hidden, &output, mnist());
        if (which == 0) {
            return output[index];
        }
        var min_h : f32 = hidden[0];
        var written : f32 = 0.0;
        k = 0;
        while (k < 128) {
            min_h = @min(min_h, hidden[k]);
            k = k + 1;
        }
        k = 0;
        while (k < 11) {
            if (output[k] != -99.0) {
                written = written + 1.0;
            }
            k = k + 1;
        }
        if (which == 1) {
            return min_h;
        }
        return written;
    }

    // which: 0 = w1.len written by init, 1 = b1[0], 2 = b2[0], 3 = largest |w1|
    fn mnist_init(which: u8) -> f32 {
        var w1 : [784 * 128]f32 = [9.0] ** (784 * 128);
        var b1 : [128]f32 = [9.0] ** 128;
        var w2 : [128 * 10]f32 = [9.0] ** (128 * 10);
        var b2 : [10]f32 = [9.0] ** 10;
        init(MLPState{ .w1 = &w1, .b1 = &b1, .w2 = &w2, .b2 = &b2 }, mnist());
        var written : f32 = 0.0;
        var largest : f32 = 0.0;
        var k : usize = 0;
        while (k < w1.len) {
            if (w1[k] != 9.0) {
                written = written + 1.0;
            }
            largest = @max(largest, @abs(w1[k]));
            k = k + 1;
        }
        if (which == 0) {
            return written;
        }
        if (which == 1) {
            return b1[0];
        }
        if (which == 2) {
            return b2[0];
        }
        return largest;
    }

    // Train a 2-8-1 network on XOR for `epochs` passes over the four cases.
    // which: 0 = total loss of the first epoch, 1 = total loss of the last epoch,
    // 2 + c = the trained network's output for case c
    fn xor(epochs: u32, which: usize) -> f32 {
        const cfg = MLPConfig{ .input_size = 2, .hidden_size = 8, .output_size = 1 };
        var w1 : [16]f32 = undefined;
        var b1 : [8]f32 = undefined;
        var w2 : [8]f32 = undefined;
        var b2 : [1]f32 = undefined;
        const state = MLPState{ .w1 = &w1, .b1 = &b1, .w2 = &w2, .b2 = &b2 };
        init(state, cfg);
        const xs : [8]f32 = [0.0, 0.0, 0.0, 1.0, 1.0, 0.0, 1.0, 1.0];
        const ts : [4]f32 = [0.0, 1.0, 1.0, 0.0];
        var hidden : [8]f32 = undefined;
        var delta : [8]f32 = undefined;
        var output : [1]f32 = undefined;
        var first : f32 = 0.0;
        var last : f32 = 0.0;
        var e : u32 = 0;
        while (e < epochs) {
            var total : f32 = 0.0;
            var c : usize = 0;
            while (c < 4) {
                total = total + train_step(xs[c * 2 .. c * 2 + 2], ts[c .. c + 1], state, &hidden, &delta, &output, 0.05, cfg);
                c = c + 1;
            }
            if (e == 0) {
                first = total;
            }
            last = total;
            e = e + 1;
        }
        if (which == 0) {
            return first;
        }
        if (which == 1) {
            return last;
        }
        forward(xs[(which - 2) * 2 .. (which - 2) * 2 + 2], state, &hidden, &output, cfg);
        return output[0];
    }

    // ═══════════════════════════════════════════════════════════
    // TDD: Tests (from .tri behaviors)
    // ═══════════════════════════════════════════════════════════

    // 784 -> 128 -> 10: exactly the 10 outputs are written, the 11th slot is untouched
    test forward_output_size
        given written = mnist_forward(2, 0)
        when spare = mnist_forward(0, 10)
        then written == 10.0 and spare == -99.0

    // The hidden layer is relu, so no hidden unit is negative
    test forward_relu_activation
        given min_hidden = mnist_forward(1, 0)
        then min_hidden >= 0.0

    // init writes every one of the 784 * 128 first-layer weights, each within sqrt(2 / 784) = 0.05051
    test init_allocation_sizes
        given written = mnist_init(0)
        when largest = mnist_init(3)
        then written == 100352.0 and largest <= 0.0506 and largest > 0.0

    test init_bias_initialization
        given b1 = mnist_init(1)
        when b2 = mnist_init(2)
        then b1 == 0.0 and b2 == 0.0

    // Backpropagation learns XOR: the loss falls by more than 100x, and each output is within 0.1
    test train_step_learns_xor
        given first = xor(2000, 0)
        when last = xor(2000, 1)
        then last < first / 100.0 and @abs(xor(2000, 2)) < 0.1 and @abs(xor(2000, 3) - 1.0) < 0.1 and @abs(xor(2000, 4) - 1.0) < 0.1 and @abs(xor(2000, 5)) < 0.1

    // ═══════════════════════════════════════════════════════════
    // TDD: Invariants (from .tri constraints)
    // ═══════════════════════════════════════════════════════════

    // input_size == MNIST_INPUT_SIZE (784)
    invariant mlp_constraint_0
        assert mnist().input_size == 784

    // output_size == MNIST_OUTPUT_SIZE (10)
    invariant mlp_constraint_1
        assert mnist().output_size == 10

    // hidden_size > 0
    invariant mlp_constraint_2
        assert mnist().hidden_size > 0

    // w1.size() == input_size * hidden_size
    invariant mlp_constraint_3
        assert mnist().input_size * mnist().hidden_size == 100352

    // w2.size() == hidden_size * output_size
    invariant mlp_constraint_4
        assert mnist().hidden_size * mnist().output_size == 1280

    // b1.size() == hidden_size
    invariant mlp_constraint_5
        assert DEFAULT_HIDDEN_SIZE == 128

    // b2.size() == output_size
    invariant mlp_constraint_6
        assert MNIST_OUTPUT_SIZE == 10
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.