Градиентный спуск
Вы узнаете
Как градиентный спуск идёт вниз по функции потерь, что добавляет момент и почему слишком большой шаг никогда не успокаивается.
Обучение это спуск под гору по функции потерь. Градиентный спуск каждый шаг сдвигает вес на -lr, умноженное на его градиент; в спеке потеря равна (x - 3)^2 от x = 0, и lr 0.1 доходит до 2.99996 за 50 шагов. Момент добавляет долю прошлого сдвига, что ускоряет длинный склон и перелетает острое дно: при 0.9 вес пролетает 3 примерно до 5.13 и, раскачиваясь, приходит к 3.09 после 50 шагов. Нестеров берёт градиент на шаг вперёд и качается меньше, примерно до 4.25. Слишком большой шаг никогда не успокаивается: при lr 1 вес навсегда скачет между 0 и 6. Спека sgd.t27 вычисляет каждый шаг.
Попробовать
Найдите наибольший шаг обучения, который ещё успокаивается без момента; затем добавьте момент 0.9 и сосчитайте качания.
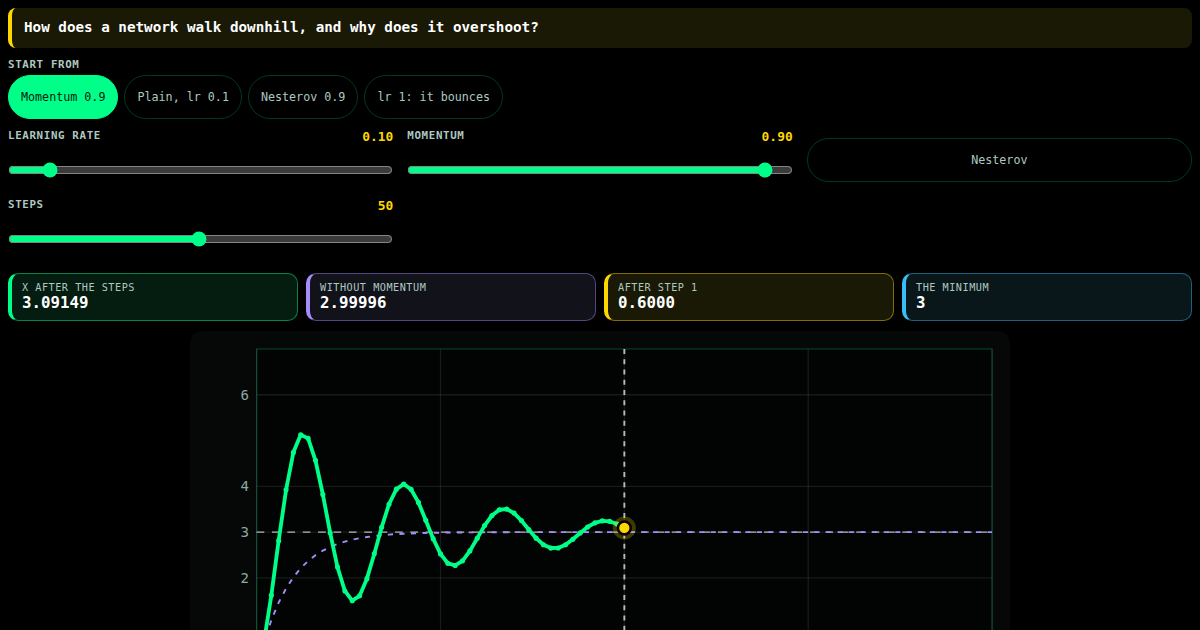
Set the learning rate and momentum and watch a weight walk from 0 to the bottom of (x - 3)^2. Plain steps creep, momentum overshoots and rings, and a rate of 1 bounces forever.
specs/ml/optimizer/sgd.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Nesterov accelerated gradient (NAG) | φ² + 1/φ² = 3 | TRINITY
// #8980: init called `new f32[n]`; update read undeclared locals; dampening and
// nesterov were ignored; and weight decay was ADDED to the parameter
// (`- v + wd * p`), which grows the weights it should shrink. update is now
// PyTorch's SGD: g = grad + wd p; v = mu v + (1 - dampening) g;
// step = g + mu v (Nesterov) or v; p = p - lr step.
module Sgd;
use base::types;
use math::constants;
// ═══════════════════════════════════════════════════════════
// 1. Constants
// ═══════════════════════════════════════════════════════════
const DEFAULT_LR : f32 = 0.01;
const DEFAULT_MOMENTUM : f32 = 0.0;
// ═══════════════════════════════════════════════════════════
// 2. Types
// ═══════════════════════════════════════════════════════════
pub const SGDConfig = struct {
learning_rate : f32,
momentum : f32,
weight_decay : f32,
dampening : f32,
nesterov : bool,
};
pub const SGDState = struct {
velocity : []f32,
};
// ═══════════════════════════════════════════════════════════
// 3. Core Functions
// ═══════════════════════════════════════════════════════════
// init: the first param_count velocities start at zero (the caller owns the buffer)
fn init(state: SGDState, param_count: u32) -> void {
var i : usize = 0;
while (i < param_count) {
state.velocity[i] = 0.0;
i = i + 1;
}
}
fn update(params: []f32, grads: []const f32, state: SGDState, config: SGDConfig) -> void {
var i : usize = 0;
while (i < params.len) {
const g = grads[i] + config.weight_decay * params[i];
var step = g;
if (config.momentum > 0.0) {
state.velocity[i] = config.momentum * state.velocity[i] + (1.0 - config.dampening) * g;
if (config.nesterov) {
step = g + config.momentum * state.velocity[i];
} else {
step = state.velocity[i];
}
}
params[i] = params[i] - config.learning_rate * step;
i = i + 1;
}
}
fn cfg(lr: f32, momentum: f32, wd: f32, nesterov: bool) -> SGDConfig {
return SGDConfig{ .learning_rate = lr, .momentum = momentum, .weight_decay = wd, .dampening = 0.0, .nesterov = nesterov };
}
// Minimise f(x) = (x - 3)^2 (gradient 2 (x - 3)) from x = 0 for `steps` steps
fn descend(lr: f32, momentum: f32, nesterov: bool, steps: u32) -> f32 {
var params : [1]f32 = [0.0];
var velocity : [1]f32 = [5.0];
const state = SGDState{ .velocity = &velocity };
init(state, 1);
var n : u32 = 0;
while (n < steps) {
const grads : [1]f32 = [2.0 * (params[0] - 3.0)];
update(¶ms, &grads, state, cfg(lr, momentum, 0.0, nesterov));
n = n + 1;
}
return params[0];
}
fn init_zeroes(index: usize) -> f32 {
var velocity : [3]f32 = [7.0, 7.0, 7.0];
init(SGDState{ .velocity = &velocity }, 3);
return velocity[index];
}
// One step on params (1, 2), grads (0.1, 0.2), momentum 0.9, weight decay 0.001
fn one_step(index: usize) -> f32 {
var params : [2]f32 = [1.0, 2.0];
const grads : [2]f32 = [0.1, 0.2];
var velocity : [2]f32 = [0.0, 0.0];
update(¶ms, &grads, SGDState{ .velocity = &velocity }, cfg(0.01, 0.9, 0.001, false));
return params[index];
}
// A step with zero gradient and weight decay shrinks the weight toward 0
fn decay_step() -> f32 {
var params : [1]f32 = [2.0];
const grads : [1]f32 = [0.0];
var velocity : [1]f32 = [0.0];
update(¶ms, &grads, SGDState{ .velocity = &velocity }, cfg(0.1, 0.0, 0.5, false));
return params[0];
}
fn valid_input() -> f32 {
return DEFAULT_LR;
}
// ═══════════════════════════════════════════════════════════
// TDD: Tests (from .tri behaviors)
// ═══════════════════════════════════════════════════════════
test "init_basic_case"
given first = init_zeroes(0)
when last = init_zeroes(2)
then first == 0.0 and last == 0.0
// v = g + wd p (momentum starts at 0): p0 = 1 - 0.01 (0.1 + 0.001) = 0.99899
test "update_basic_case"
given p0 = one_step(0)
when p1 = one_step(1)
then p0 != 1.0 and p1 != 2.0 and @abs(p0 - 0.99899) < 0.000001 and @abs(p1 - (2.0 - 0.01 * 0.202)) < 0.000001
// Weight decay pulls the weight toward 0: 2 - 0.1 * 0.5 * 2 = 1.9
test "update_weight_decay_shrinks"
given result = decay_step()
then @abs(result - 1.9) < 0.000001
// Plain, momentum and Nesterov SGD all reach the minimum at 3
test "update_descends_a_quadratic"
given plain = descend(0.1, 0.0, false, 100)
when heavy = descend(0.05, 0.9, false, 300)
then @abs(plain - 3.0) < 0.0001 and @abs(heavy - 3.0) < 0.0001 and @abs(descend(0.05, 0.9, true, 300) - 3.0) < 0.0001
// ═══════════════════════════════════════════════════════════
// TDD: Invariants (from .tri constraints)
// ═══════════════════════════════════════════════════════════
// learning_rate > 0
invariant sgd_constraint_0
assert valid_input() > 0.0
// 0 <= momentum < 1
invariant sgd_constraint_1
assert DEFAULT_MOMENTUM >= 0.0 and DEFAULT_MOMENTUM < 1.0
// weight_decay >= 0: a non-negative decay never grows a weight with zero gradient
invariant sgd_constraint_2
assert decay_step() < 2.0
// params.size() == grads.size(): every parameter moves
invariant sgd_constraint_3
assert one_step(0) != 1.0 and one_step(1) != 2.0
// If momentum > 0: state.velocity.size() == params.size() -- init zeroes all of it
invariant sgd_constraint_4
assert init_zeroes(1) == 0.0
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.