Эмбеддинги
Вы узнаете
Как токен превращается в строку чисел и почему обучение меняет только прочитанные строки.
Сеть не умеет умножать слово, поэтому каждый токен это индекс в таблице с одной строкой чисел на токен, а поиск токена копирует его строку. В спеке в таблице 4 токена шириной 2, и строка v хранит (10 v, 10 v + 1), так что токен 2 читает (20, 21). Обучение отправляет градиент назад только в прочитанные строки, а токен, прочитанный дважды, собирает оба: строки градиента (1, 2) и (3, 4) на токене 2 складываются в (4, 6). Спека embedding_layer.t27 вычисляет поиск и градиент.
Попробовать
Прочитайте токен 2 дважды, а затем токены 1 и 3; каждый раз сосчитайте строки, где градиент не 0.
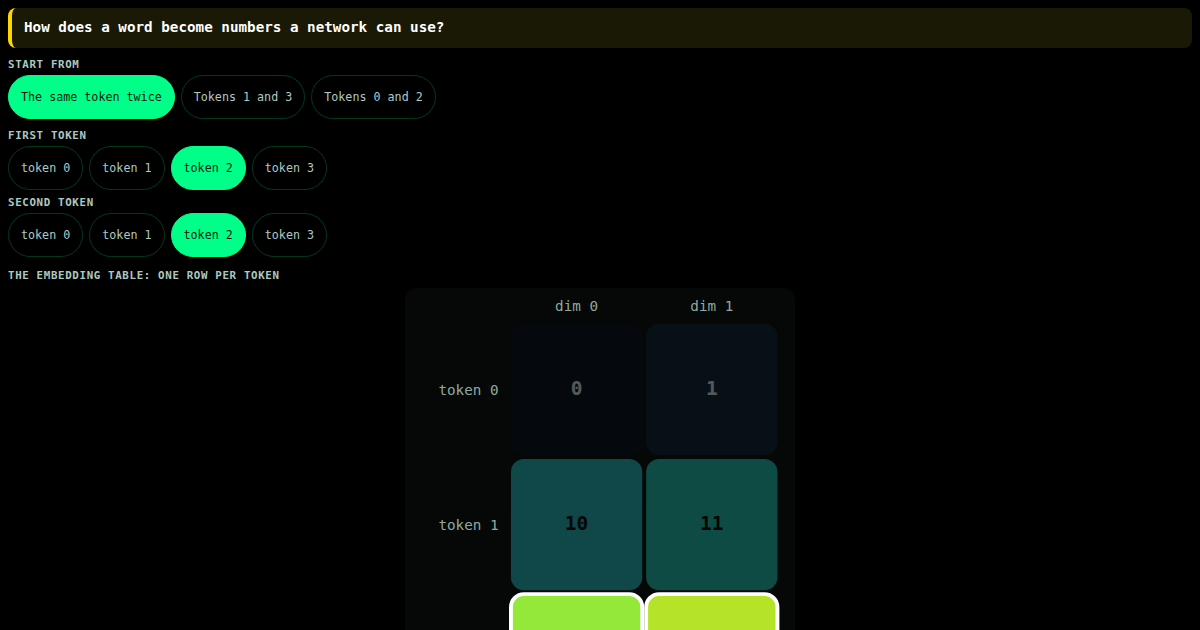
Pick two tokens: each one copies its row out of the table. Then the gradient flows back only into the rows that were read, and a token read twice collects both.
specs/ml/layers/embedding_layer.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Embeddings are learned parameters | φ² + 1/φ² = 3 | TRINITY

// #8980: forward only asserted its arguments and wrote nothing, the tests called
// undeclared `test_input_forward` / `test_input_init` and asserted
// `result != undefined`, and the invariants asserted `true`. forward now looks each
// token's row up in W (vocab_size x d_model, row-major), backward adds each
// gradient row back into the row it came from, and init fills W deterministically.

module Embedding;
    use base::types;
    use math::constants;

    // ═══════════════════════════════════════════════════════════
    // 1. Constants
    // ═══════════════════════════════════════════════════════════

    const DEFAULT_D_MODEL : u32 = 64;

    // ═══════════════════════════════════════════════════════════
    // 2. Types
    // ═══════════════════════════════════════════════════════════

    pub const EmbeddingConfig = struct {
        vocab_size : u32,
        d_model : u32,
    };

    pub const EmbeddingWeights = struct {
        W : []f32,
    };

    // ═══════════════════════════════════════════════════════════
    // 3. Core Functions
    // ═══════════════════════════════════════════════════════════

    // embeddings[t * d + j] = W[token_ids[t] * d + j]: one row of W per token
    fn forward(token_ids: []const u32, weights: EmbeddingWeights, embeddings: []f32, config: EmbeddingConfig) -> void {
        const d : usize = config.d_model;
        var t : usize = 0;
        while (t < token_ids.len) {
            const row : usize = token_ids[t];
            var j : usize = 0;
            while (j < d) {
                embeddings[t * d + j] = weights.W[row * d + j];
                j = j + 1;
            }
            t = t + 1;
        }
    }

    // grad_W[token_ids[t]] += grad_embeddings[t]: a token seen twice collects both rows
    fn backward(token_ids: []const u32, grad_embeddings: []const f32, grad_W: []f32, config: EmbeddingConfig) -> void {
        const d : usize = config.d_model;
        var t : usize = 0;
        while (t < token_ids.len) {
            const row : usize = token_ids[t];
            var j : usize = 0;
            while (j < d) {
                grad_W[row * d + j] = grad_W[row * d + j] + grad_embeddings[t * d + j];
                j = j + 1;
            }
            t = t + 1;
        }
    }

    // Deterministic init in [-0.5, 0.5) / sqrt(d_model): a fixed hash of (row, column), so
    // two runs start from the same weights
    fn init(weights: EmbeddingWeights, config: EmbeddingConfig) -> void {
        const d : usize = config.d_model;
        const scale : f32 = 1.0 / sqrt(@as(f32, @floatFromInt(d)));
        var k : usize = 0;
        while (k < config.vocab_size * d) {
            const h : u32 = @as(u32, @intCast((k * 2654435761) % 1000));
            weights.W[k] = (@as(f32, @floatFromInt(h)) / 1000.0 - 0.5) * scale;
            k = k + 1;
        }
    }

    // vocab 4, d_model 2, W row v = (10 v, 10 v + 1)
    fn cfg() -> EmbeddingConfig {
        return EmbeddingConfig{ .vocab_size = 4, .d_model = 2 };
    }

    fn lookup_at(a: u32, b: u32, index: usize) -> f32 {
        var w : [8]f32 = [0.0, 1.0, 10.0, 11.0, 20.0, 21.0, 30.0, 31.0];
        const ids : [2]u32 = [a, b];
        var out : [4]f32 = [-1.0] ** 4;
        forward(&ids, EmbeddingWeights{ .W = &w }, &out, cfg());
        return out[index];
    }

    // grad_W[index] after backward of ids (a, b) with gradient rows (1, 2) and (3, 4)
    fn grad_at(a: u32, b: u32, index: usize) -> f32 {
        const ids : [2]u32 = [a, b];
        const grads : [4]f32 = [1.0, 2.0, 3.0, 4.0];
        var grad_w : [8]f32 = [0.0] ** 8;
        backward(&ids, &grads, &grad_w, cfg());
        return grad_w[index];
    }

    fn init_at(index: usize) -> f32 {
        var w : [8]f32 = [9.0] ** 8;
        init(EmbeddingWeights{ .W = &w }, cfg());
        return w[index];
    }

    fn valid_input() -> u32 {
        return cfg().vocab_size * cfg().d_model;
    }

    // ═══════════════════════════════════════════════════════════
    // TDD: Tests (from .tri behaviors)
    // ═══════════════════════════════════════════════════════════

    // ids (2, 0): rows (20, 21) then (0, 1)
    test forward_basic_case
        given first = lookup_at(2, 0, 0)
        when last = lookup_at(2, 0, 3)
        then first == 20.0 and lookup_at(2, 0, 1) == 21.0 and lookup_at(2, 0, 2) == 0.0 and last == 1.0

    // Every weight is written, inside [-0.5, 0.5) / sqrt(2), and init is reproducible
    test init_basic_case
        given first = init_at(0)
        when last = init_at(7)
        then first != 9.0 and last != 9.0 and @abs(first) <= 0.36 and @abs(last) <= 0.36 and init_at(5) == init_at(5) and init_at(1) != init_at(2)

    // A token seen twice collects both gradient rows; an unseen row stays 0
    test backward_accumulates_repeated_tokens
        given row1 = grad_at(1, 1, 2)
        when unseen = grad_at(1, 1, 0)
        then row1 == 4.0 and grad_at(1, 1, 3) == 6.0 and unseen == 0.0 and grad_at(1, 3, 6) == 3.0

    // ═══════════════════════════════════════════════════════════
    // TDD: Invariants (from .tri constraints)
    // ═══════════════════════════════════════════════════════════

    // vocab_size > 0
    invariant embedding_constraint_0
        assert cfg().vocab_size > 0

    // d_model > 0
    invariant embedding_constraint_1
        assert cfg().d_model > 0 and DEFAULT_D_MODEL > 0

    // W.size() == vocab_size * d_model
    invariant embedding_constraint_2
        assert valid_input() == 8

    // token_ids must be in [0, vocab_size): the last id reads the last row
    invariant embedding_constraint_3
        assert lookup_at(3, 3, 1) == 31.0

    // "Embedding dimension affects model capacity": each token gets d_model numbers
    invariant embedding_constraint_4
        assert lookup_at(1, 2, 1) == 11.0 and lookup_at(1, 2, 2) == 20.0

    // "Larger vocab requires larger d_model": the init scale shrinks as 1 / sqrt(d_model)
    invariant embedding_constraint_5
        assert 1.0 / sqrt(@as(f32, 64.0)) < 1.0 / sqrt(@as(f32, 2.0))

    // "Pre-trained embeddings transfer well": forward is a pure lookup, so loaded rows come out unchanged
    invariant embedding_constraint_6
        assert lookup_at(0, 1, 0) == 0.0 and lookup_at(0, 1, 2) == 10.0
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.