Adam: момент и масштаб
Вы узнаете
Как Adam соединяет момент со скользящим масштабом и почему поправка смещения делает шаг 1 фиксированного размера.
Adam соединяет обе идеи: m, скользящее среднее градиента, как в моменте, и v, скользящее среднее его квадрата, как в RMSProp; шаг равен lr m / sqrt(v). Оба начинают с 0 и поначалу слишком малы, поэтому Adam делит их на 1 - beta^t, и на шаге 1 это делает сдвиг ровно lr, умноженным на знак градиента: градиенты 2, -40 и 0.5 сдвигают свои веса на одинаковые 0.001. На чаше спеки (x - 3)^2 при lr 0.1 Adam поднимается от 0, перелетает примерно до 3.18 и успокаивается на 3.00005 к шагу 200. Спека adam.t27 вычисляет каждый шаг.
Попробовать
Дайте трём градиентам очень разные размеры и прочитайте веса после шага 1; затем найдите, где путь достигает вершины.
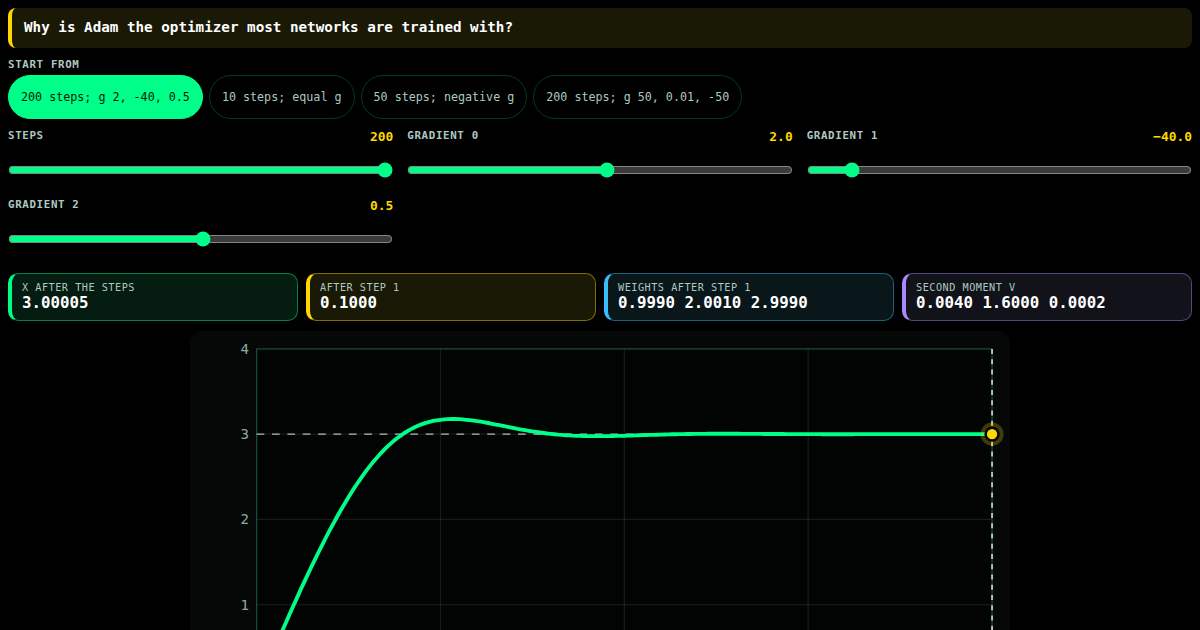
Watch Adam carry a weight from 0 to the minimum at 3, then set three gradients of any size: the bias correction makes the first step lr times their sign, whatever their size.
specs/ml/optimizer/adam.t27
// SPDX-License-Identifier: Apache-2.0
// t27/specs/
// Adam adapts learning rate per parameter | φ² + 1/φ² = 3 | TRINITY
// #8980: step only checked its gradients with an undeclared `math::is_finite`
// and updated nothing; the tests asserted `result != undefined`. step is now
// Adam (Kingma and Ba, 2015) with bias correction. It refuses (returns false,
// changes nothing) when a gradient is NaN or infinite, which is what the old body
// validated.
module Adam;
use base::types;
use math::constants;
// ═══════════════════════════════════════════════════════════
// 1. Constants
// ═══════════════════════════════════════════════════════════
const DEFAULT_BETA1 : f32 = 0.9;
const DEFAULT_BETA2 : f32 = 0.999;
const DEFAULT_EPSILON : f32 = 1e-8;
// ═══════════════════════════════════════════════════════════
// 2. Types
// ═══════════════════════════════════════════════════════════
pub const AdamConfig = struct {
learning_rate : f32,
beta1 : f32,
beta2 : f32,
epsilon : f32,
weight_decay : f32,
};
// ═══════════════════════════════════════════════════════════
// 3. Core Functions
// ═══════════════════════════════════════════════════════════
// b^t for a whole t >= 0
fn powi(b: f32, t: u32) -> f32 {
var r : f32 = 1.0;
var n : u32 = 0;
while (n < t) {
r = r * b;
n = n + 1;
}
return r;
}
// NaN is the one value not equal to itself; inf - inf is NaN
fn is_finite(x: f32) -> bool {
return x == x and (x - x) == (x - x);
}
// One Adam step number t (1-based) over params, with moment buffers m and v:
// g = grad + wd p
// m = b1 m + (1 - b1) g v = b2 v + (1 - b2) g^2
// m_hat = m / (1 - b1^t) v_hat = v / (1 - b2^t)
// p = p - lr m_hat / (sqrt(v_hat) + eps)
fn step(params: []f32, grads: []const f32, m: []f32, v: []f32, t: u32, config: AdamConfig) -> bool {
var i : usize = 0;
while (i < grads.len) {
if (!is_finite(grads[i])) {
return false;
}
i = i + 1;
}
const c1 = 1.0 - powi(config.beta1, t);
const c2 = 1.0 - powi(config.beta2, t);
i = 0;
while (i < params.len) {
const g = grads[i] + config.weight_decay * params[i];
m[i] = config.beta1 * m[i] + (1.0 - config.beta1) * g;
v[i] = config.beta2 * v[i] + (1.0 - config.beta2) * g * g;
const m_hat = m[i] / c1;
const v_hat = v[i] / c2;
params[i] = params[i] - config.learning_rate * m_hat / (sqrt(v_hat) + config.epsilon);
i = i + 1;
}
return true;
}
fn cfg(lr: f32) -> AdamConfig {
return AdamConfig{ .learning_rate = lr, .beta1 = DEFAULT_BETA1, .beta2 = DEFAULT_BETA2, .epsilon = DEFAULT_EPSILON, .weight_decay = 0.0 };
}
// which: 0 = param, 1 = m, 2 = v after one step on params (1, 2, 3) with grads (g0, g1, g2)
fn first_step(g0: f32, g1: f32, g2: f32, which: u8, index: usize) -> f32 {
var params : [3]f32 = [1.0, 2.0, 3.0];
const grads : [3]f32 = [g0, g1, g2];
var m : [3]f32 = [0.0] ** 3;
var v : [3]f32 = [0.0] ** 3;
_ = step(¶ms, &grads, &m, &v, 1, cfg(0.001));
if (which == 1) {
return m[index];
}
if (which == 2) {
return v[index];
}
return params[index];
}
// a / b at run time, where IEEE gives NaN for 0 / 0 and inf for 1 / 0
fn ratio(a: f32, b: f32) -> f32 {
return a / b;
}
fn accepts(g: f32) -> bool {
var params : [1]f32 = [1.0];
const grads : [1]f32 = [g];
var m : [1]f32 = [0.0];
var v : [1]f32 = [0.0];
return step(¶ms, &grads, &m, &v, 1, cfg(0.001)) and params[0] != 1.0;
}
// Minimise (x - 3)^2 from 0
fn descend(steps: u32) -> f32 {
var params : [1]f32 = [0.0];
var m : [1]f32 = [0.0];
var v : [1]f32 = [0.0];
var t : u32 = 1;
while (t <= steps) {
const grads : [1]f32 = [2.0 * (params[0] - 3.0)];
_ = step(¶ms, &grads, &m, &v, t, cfg(0.1));
t = t + 1;
}
return params[0];
}
// ═══════════════════════════════════════════════════════════
// TDD: Tests (from .tri behaviors)
// ═══════════════════════════════════════════════════════════
// Bias correction makes the first step lr * sign(g), whatever |g| is
test step_basic_case
given p0 = first_step(0.1, -5.0, 0.0, 0, 0)
when p1 = first_step(0.1, -5.0, 0.0, 0, 1)
then @abs(p0 - 0.999) < 0.000001 and @abs(p1 - 2.001) < 0.000001 and first_step(0.1, -5.0, 0.0, 0, 2) == 3.0
// m = 0.1 g and v = 0.001 g^2 after the first step
test step_with_gradients
given m2 = first_step(0.1, 0.2, 0.3, 1, 2)
when v2 = first_step(0.1, 0.2, 0.3, 2, 2)
then @abs(m2 - 0.03) < 0.0000001 and @abs(v2 - 0.00009) < 0.0000001
// Finite gradients are applied; NaN and inf are refused
test step_validates_gradients
given ok = accepts(1.5) and accepts(-2.3) and accepts(4.7)
when refused = !accepts(ratio(0.0, 0.0)) and !accepts(ratio(1.0, 0.0))
then ok and refused
test step_descends_a_quadratic
given result = descend(500)
then @abs(result - 3.0) < 0.01
invariant adam_betas_are_below_one
assert DEFAULT_BETA1 < 1.0 and DEFAULT_BETA2 < 1.0 and DEFAULT_BETA1 < DEFAULT_BETA2 and DEFAULT_EPSILON > 0.0
Все уроки
Модуль 1 · Один нейрон
Нейрон складывает входы и изгибает сумму: ReLU, сигмоида и tanh, и где каждая перестаёт пропускать градиент назад.
Модуль 2 · Новые изгибы
Гладкие кривые нынешних моделей: GELU с провалом, Swish с ручкой и ELU с полом вместо обрыва.
Модуль 3 · Слой
Что окружает нейроны: softmax превращает оценки в выбор, эмбеддинг превращает слово в числа, dropout выключает нейроны.
Модуль 4 · Картинки
Чтение картинки по участкам: окно, усреднённое по участку, max pooling и пакетная нормализация признаков разного масштаба.
Модуль 5 · Ошибка
Насколько неверна догадка, одним числом: среднеквадратичная ошибка, перекрёстная энтропия для вероятностей и функция Хьюбера для выбросов.
Модуль 6 · Под гору
Спуск по функции потерь: градиентный спуск с моментом, RMSProp без оглядки на величину градиента и Adam, который соединяет оба.
Модуль 7 · Обучение
Откуда берутся градиенты и чего они добиваются: обратное распространение через слой, сеть, которая учит XOR, и LAMB для больших пакетов.
Модуль 8 · Память и внимание
Сети, которые читают последовательность: рекуррентная ячейка и её затухающее эхо, вентили LSTM и внимание ко всем позициям сразу.
Модуль 9 · Трансформер и награда
Части трансформера и агента: позиции как часы, один блок энкодера и PPO, который учится на награде без рывков.